Une fonction qui ne produit pas de chiffre d’affaires, jugée sur un chiffre d’affaires. C’est la position exacte des cellules de veille concurrentielle dans la plupart des entreprises de taille moyenne, et c’est ce qui les condamne au demi-poste.
Cet article part d’une phrase que tout le monde cite et que personne n’applique, la maxime de Sun Tzu sur la connaissance de l’ennemi et de soi. Il en tire un dispositif de mesure complet : cinq étages, six indicateurs, un test de retrait de quatre semaines. À la fin, la question change de forme. Elle n’est plus « combien la veille rapporte », mais « qu’a-t-elle vu avant les autres ».
À retenir
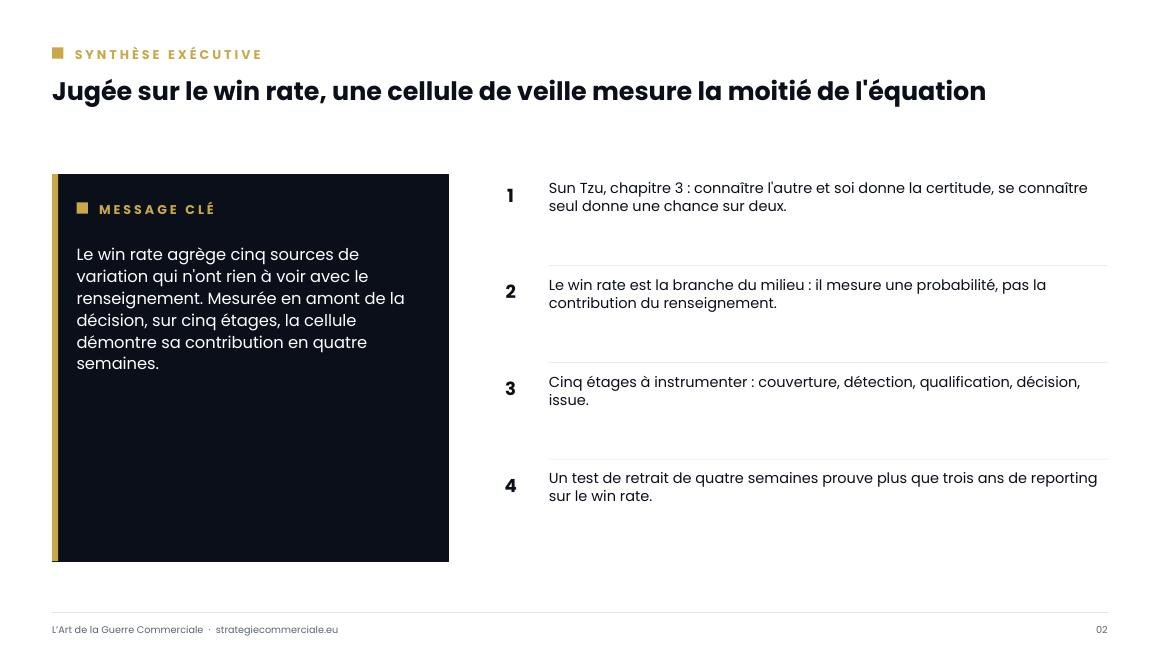
- Le win rate, c’est-à-dire le taux de victoire sur les affaires closes, mesure l’issue d’une bataille après que d’autres facteurs ont pesé. La qualité du renseignement y pèse à la marge.
- Sun Tzu pose le problème au chapitre 3 : connaître l’autre et se connaître donne la certitude, se connaître seul donne une chance sur deux, et c’est exactement la situation d’une cellule jugée sur son taux de victoire.
- La contribution d’une cellule de veille se mesure en amont de la décision, sur cinq étages : couverture, détection, qualification, décision, issue.
- Le seul indicateur qui regarde du côté du concurrent est le taux de surprise : la part des affaires perdues où le mouvement décisif a été découvert trop tard.
- L’agent couvre la collecte et le pré-tri des signaux ; les heures ainsi libérées sont la condition de toute mesure.
- Un test de retrait de quatre semaines produit une preuve plus solide que trois ans de reporting sur le win rate.
Sommaire
I. Le champ de bataille moderne : la cellule jugée sur un indicateur qu’elle ne contrôle pas
1.1 La scène, et ce qu’elle dit du problème
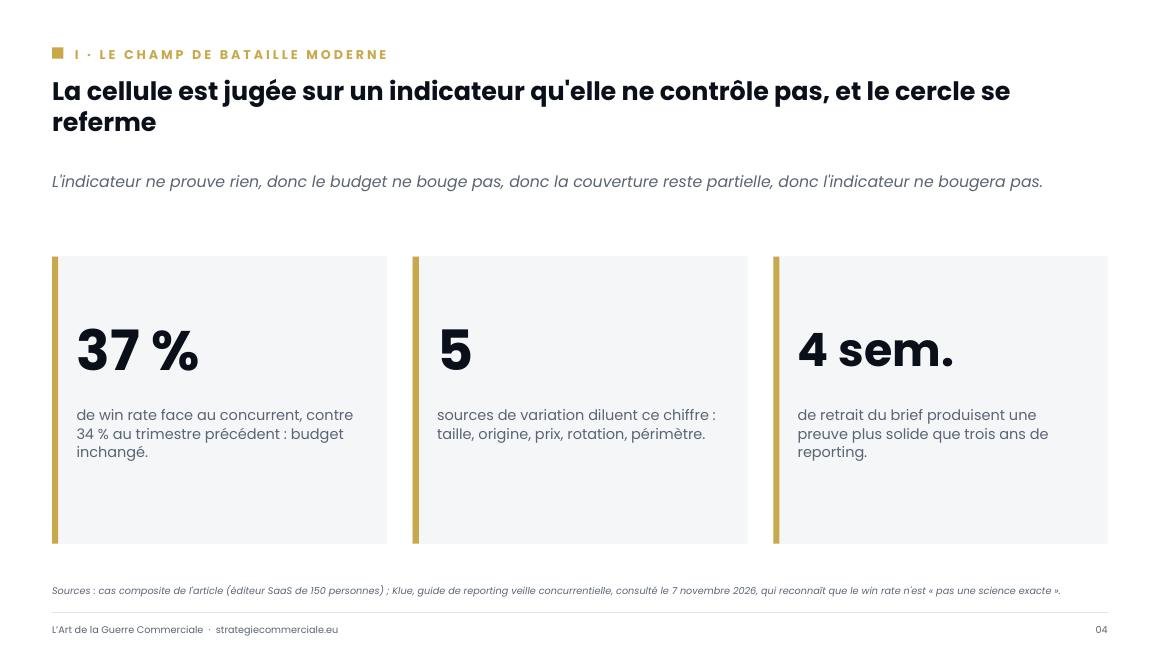
Une revue trimestrielle, dans un éditeur SaaS de cent cinquante personnes. Le cas est composite : il assemble des situations observées dans plusieurs entreprises. La direction demande à la cellule de veille concurrentielle, deux personnes à mi-temps rattachées au marketing, ce que son travail a rapporté ce trimestre. La réponse est un chiffre : le win rate face au principal concurrent est passé de 34 % à 37 %.
La direction acquiesce et n’augmente pas le budget. Personne ne pose la question qui tue : ce trimestre, un concurrent a lancé un module qui vous manque, un autre a recruté trois ingénieurs sur un segment que vous visez, un troisième a changé de partenaire d’intégration. Les trois informations sont dans le brief. Aucune n’apparaît dans le chiffre.
Le problème n’est pas que la cellule travaille mal. Le problème est que l’indicateur censé prouver sa valeur mesure autre chose. Et ce n’est pas une erreur de débutant : c’est le point d’équilibre naturel d’une fonction sans ligne de résultat propre.
1.2 Le cercle de la preuve
Le mécanisme est simple, et il se répète dans la majorité des organisations de taille moyenne.
Faute d’indicateur direct, la veille concurrentielle est jugée sur l’indicateur commercial le plus disponible : le taux de victoire face à un concurrent nommé. Or cet indicateur agrège au moins cinq sources de variation qui n’ont rien à voir avec la qualité du renseignement :
- le mix de taille d’affaires, puisqu’on ne gagne pas un contrat à 15 000 euros comme un contrat à 300 000 ;
- l’origine de l’affaire, l’inbound n’ayant pas le même taux de conversion que la prospection sortante ;
- la pression tarifaire du trimestre, qui déplace le win rate sans qu’aucune information nouvelle n’ait circulé ;
- la rotation des commerciaux, un portefeuille repris perdant mécaniquement des points pendant deux trimestres ;
- le périmètre concurrentiel lui-même, quand un acteur voisin qui devient soudain un concurrent sur un appel d’offres.
La cellule est donc principalement évaluée sur un indicateur qu’elle ne contrôle pas, sur lequel elle ne peut agir qu’à la marge, et qui ne varie de façon lisible qu’à une condition : que tout le reste soit stable. Dans une entreprise qui grandit, rien ne reste stable.
D’où le cercle : l’indicateur ne prouve rien, donc le budget ne bouge pas, donc la cellule reste à un demi-poste, donc la couverture reste partielle, donc l’indicateur ne bougera pas. Le cercle ne se casse pas en travaillant plus. Il se casse en changeant d’étage de mesure.
1.3 Ce que le marché reconnaît lui-même
Il faut être juste et rendre à César ce qui appartient à César. Ce constat vient des vendeurs de logiciels de veille, qui ont pourtant tout intérêt à le nier.
Klue, l’un des éditeurs de référence de la catégorie, l’écrit noir sur blanc dans son guide de reporting : isoler l’impact sur le revenu d’un programme de veille concurrentielle est un défi, et le win rate n’est, de son propre aveu, « pas une science exacte ». Leur exemple est plus parlant que la formule : si une commerciale explose son quota ce trimestre, est-ce grâce au renseignement concurrentiel qu’elle a consulté ? Pas nécessairement ; elle a peut-être simplement mieux construit la relation, ou le produit venait de livrer une fonctionnalité décisive.
Le remède que l’éditeur propose ensuite vaut d’être regardé de près, parce qu’il est représentatif de ce que fait le marché : comparer le taux de victoire des commerciaux qui utilisent les fiches concurrentielles à celui de ceux qui ne les utilisent pas. L’écart mesuré est ensuite monétisé en chiffre d’affaires perdu.
Le raisonnement a cependant une faille majeure : ce ne sont pas les fiches qui rendent bons, ce sont les bons qui lisent les fiches. Le biais de sélection, c’est-à-dire le fait que le groupe étudié diffère du groupe témoin par autre chose que ce qu’on mesure, n’est pas corrigé. La comparaison mesure la rigueur des commerciaux au moins autant que la valeur du renseignement.
Cette approche ne doit pas être écartée pour autant. Elle a besoin d’être complétée vers l’amont, là où la cellule est effectivement la cause de ce qui se produit.
II. Le miroir stratégique : Sun Tzu, chapitre 3, la branche du milieu
2.1 Une phrase que tout le monde cite, personne n’applique
« Connais ton ennemi et connais-toi toi-même, et tu livreras cent batailles sans danger. » La phrase est partout : séminaires de vente, présentations commerciales, couvertures de livres de management. Elle est aussi tronquée, et c’est dommage, parce que la partie coupée est précisément celle qui parle de mesure.
Voici le passage, à la fin du chapitre 3 de L’Art de la guerre, celui que les éditions françaises intitulent « De l’attaque par le stratagème » :
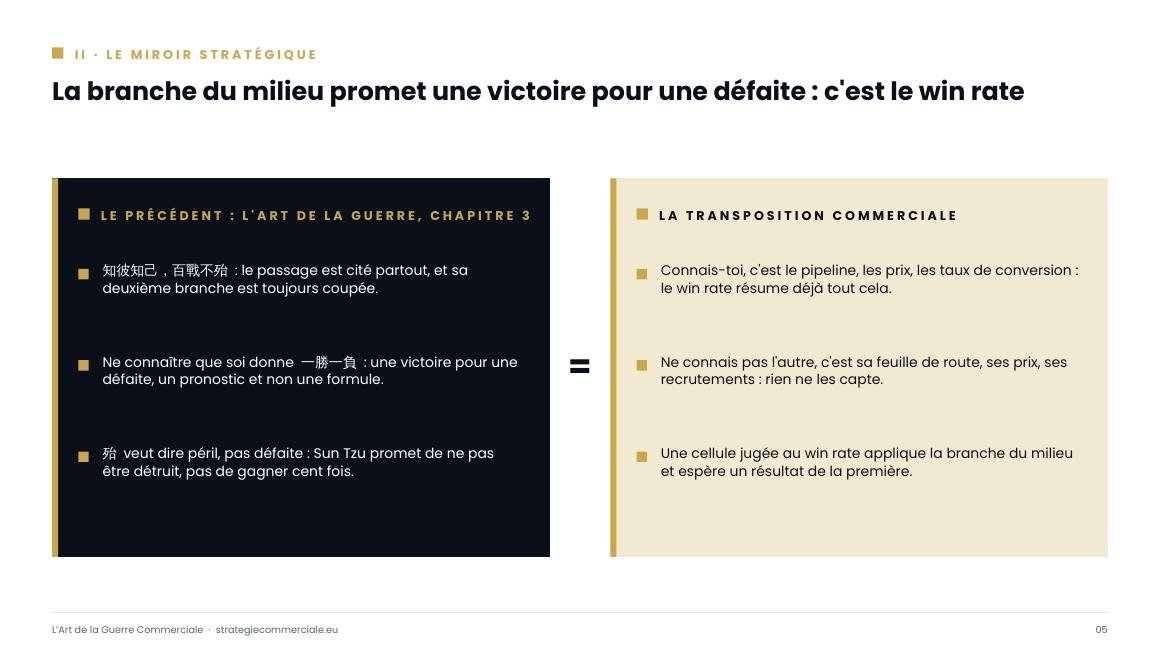
知彼知己,百戰不殆;不知彼而知己,一勝一負;不知彼,不知己,每戰必殆
« Connais l’autre et connais-toi : cent batailles sans péril. Ne connais pas l’autre mais connais-toi : une victoire, une défaite. Ne connais ni l’autre ni toi : chaque bataille est perdue. »
Trois branches distinctes, et non une maxime à prendre en bloc.
La première promet la sécurité à qui détient les deux connaissances. La troisième promet la défaite à qui n’en détient aucune. La deuxième, celle que l’on oublie toujours, promet une victoire pour une défaite, soit un taux de succès d’environ 50 %. Ce n’est pas une formule littéraire : c’est un pronostic sur une situation de connaissance asymétrique.
2.2 La branche du milieu, c’est le win rate
La deuxième branche décrit une situation précise : on connaît ses propres forces, on ignore celles de l’adversaire. Traduite terme à terme, elle décrit une cellule de veille.
- « Connais-toi » : votre pipeline, vos prix, vos marges, vos taux de conversion, vos affaires gagnées et perdues. L’entreprise mesure déjà tout cela, et c’est exactement ce que résume un win rate.
- « Ne connais pas l’autre » : sa feuille de route, ses mouvements tarifaires, ses recrutements, ses partenariats, ses dépôts de brevets. C’est ce que produit une cellule de veille, et c’est précisément ce qu’aucun indicateur interne ne capte.
Une entreprise qui évalue sa veille au win rate mesure donc la moitié de l’équation que Sun Tzu déclarait insuffisante. Elle applique la branche du milieu et espère un résultat de la première.
L’image militaire est plus simple qu’elle n’en a l’air. Une armée qui jugerait de sa capacité à vaincre uniquement sur ses victoires passées mesurerait sa propre exécution, sans rien savoir de la difficulté du terrain qu’on lui oppose. Le jour où se présente un ennemi retranché sur une hauteur, avec des effectifs supérieurs à tout ce qu’elle a affronté, son palmarès cesse de lui être utile. Il raconte ce qu’elle a su faire contre des adversaires qu’elle connaissait. Il ne dit rien de ce qu’elle vaut contre celui qu’elle n’a pas étudié.
C’est la position exacte d’une cellule jugée sur son taux de victoire. Le chiffre monte et descend au gré des probabilités et du hasard, et plus personne ne distingue ce qui vient du renseignement de ce qui vient des circonstances.
Sun Tzu ne dit d’ailleurs pas que la branche du milieu est mauvaise. Il dit qu’elle est indécidable : un taux de 50 % ne s’améliore pas par l’effort, il s’améliore par la connaissance qui manque. C’est une invitation à instrumenter l’autre côté, pas à travailler plus fort du côté que l’on maîtrise déjà.
2.3 Une précision de traduction qui compte
Le caractère 殆 ne veut pas dire « défaite », mais « péril », « danger ». La formule populaire « cent batailles sans danger » est donc juste ; celle qui promet « cent victoires » est une glose tardive, plus vendeuse que fidèle. Giles, sinologue britannique, traduisait en 1910 par you need not fear the result of a hundred battles, ce qui conserve l’idée : pas la garantie de gagner, la garantie de ne pas être détruit.
Cette nuance n’est pas de l’érudition gratuite. Elle déplace l’objectif. Une cellule de veille ne promet pas de gagner chaque affaire. Elle promet qu’aucune affaire ne sera perdue par ignorance, ce qui est à la fois plus modeste et infiniment plus mesurable.
2.4 Ce que Sun Tzu mesurait avant la bataille
Le chapitre 3 s’ouvre sur une hiérarchie : le meilleur est de défaire les projets de l’adversaire, puis ses alliances, puis son armée, et le pire est d’assiéger des villes. Toute la progression repose sur une information obtenue avant l’engagement.
Le chapitre 13, celui des espions, enfonce le clou : la connaissance anticipée vient des hommes renseignés, jamais des dieux (replacé dans son contexte, cela signifie qu’elle ne tombe pas du ciel), et elle constitue un investissement. Un demi-poste de veille, c’est exactement le budget d’un service de renseignement qu’on n’a pas voulu payer, et dont on s’étonne ensuite qu’il ne produise pas de certitude.
III. L’ordre de bataille : mesurer le renseignement, pas l’issue
3.1 Pourquoi cette mesure devient possible maintenant
Il existe une raison simple pour laquelle les cellules de veille ne se mesurent pas : elles n’en ont pas le temps. La collecte occupe l’essentiel des heures disponibles, et la mesure commence toujours par un travail ingrat : relire des comptes rendus, retrouver la date de publication d’un signal et la comparer à celle où l’équipe l’a appris, interroger des commerciaux sur des affaires closes depuis trois mois. Deux personnes à mi-temps qui passent leurs journées à ouvrir des pages tarifaires ne feront jamais ce travail.
C’est ici que l’IA change quelque chose, et pas où on l’attend. Elle ne rend pas la veille plus intelligente. Elle abaisse trois coûts de collecte, et trois seulement :
- l’accès aux sources, puisqu’un agent lit pages publiques, offres d’emploi et avis clients sans qu’un analyste ouvre un onglet, et peut ajouter ou suggérer de nouvelles sources de sa propre initiative ;
- la cadence, puisqu’il tourne chaque jour là où la note mensuelle imposait un cycle collecte, tri, analyse.
- la forme, puisqu’il produit un brief normalisé, comparable d’une semaine à l’autre.
Les heures récupérées ne valent que par l’usage qu’on en fait. Elles se placent à deux endroits précis : l’arbitrage des signaux que la grille laisse en zone grise, et la revue de perte. Ce sont les deux seuls postes où le jugement humain produit de la mesure au lieu de consommer du temps.
Il y a néanmoins des tâches pour lesquelles un agent de veille concurrentielle ne peut se substituer à un humain et il faut en avoir conscience :
- Il ne hiérarchise pas un signal par rapport à votre position, parce que cette hiérarchie dépend de vos engagements en cours.
- Il applique une grille de qualification, il n’en valide pas les cas limites : distinguer un test tarifaire d’un repositionnement suppose de connaître l’histoire du concurrent et le contexte d’une page modifiée.
- Il ne décide pas, parce que la décision appartient à celui qui en porte la conséquence.
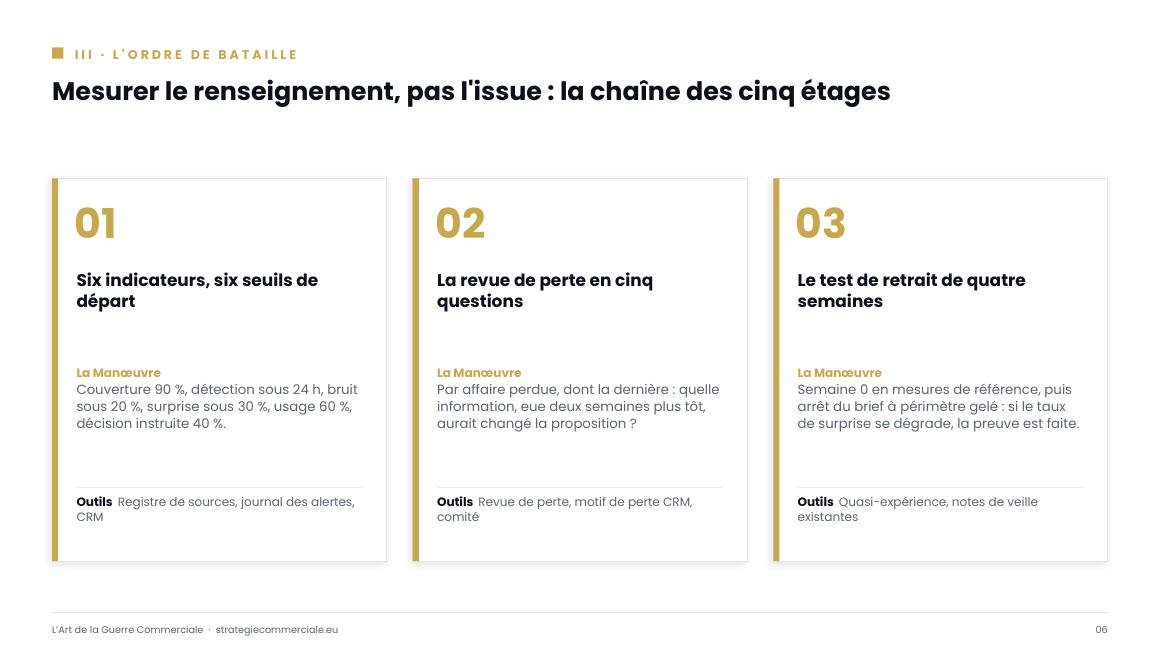
Reste à savoir quoi mesurer. La chaîne qui suit tient en cinq étages. L’agent en couvre les deux premiers sans réserve, puisqu’il interroge les sources et horodate les signaux dès leur publication. Il attaque le troisième en pré-tri dès qu’on lui donne une grille de qualification, celle décrite plus bas : il classe, il ne tranche pas les cas limites. Les deux derniers étages restent humains, parce qu’ils engagent votre position et votre décision.
3.2 La chaîne du renseignement, cinq étages
Une cellule de veille ne produit pas de chiffre d’affaires. Elle produit une suite d’états intermédiaires, et chacun est mesurable. C’est là que la mesure doit se faire : sur la chaîne, en amont du résultat commercial.
| Étage | Ce que la cellule produit | Indicateur principal |
|---|---|---|
| Couverture | La liste des sources effectivement surveillées | Taux de couverture des sources |
| Détection | Le signal, horodaté, dès sa publication | Délai de détection |
| Qualification | Le tri entre mouvement réel et bruit | Taux de bruit |
| Décision | La modification d’une décision commerciale | Taux de décision instruite |
| Issue | L’affaire gagnée ou perdue | Taux de surprise, puis win rate |
Le win rate occupe la dernière case, après que plusieurs facteurs ont dilué l’effet du renseignement. Mesurer cette case quand les quatre précédentes sont vides, c’est constater un résultat sans connaître sa cause, et appeler cela une preuve.
3.3 Les six indicateurs, avec leur formule et leur seuil
Voici le tableau de bord complet. Les seuils sont des points de départ à calibrer sur votre historique, pas des benchmarks sectoriels.
| Indicateur | Formule | Source de la donnée | Seuil de départ | Fréquence |
|---|---|---|---|---|
| Taux de couverture | sources actives / sources déclarées critiques | registre de sources tenu par la cellule | 90 % | mensuelle |
| Délai de détection | médiane (date du brief − date de publication) | horodatage du brief et date du signal | moins de 24 h pour les signaux notés 7 ou plus | hebdomadaire |
| Taux de bruit | alertes infirmées / alertes émises | journal des alertes avec statut | moins de 20 % | mensuelle |
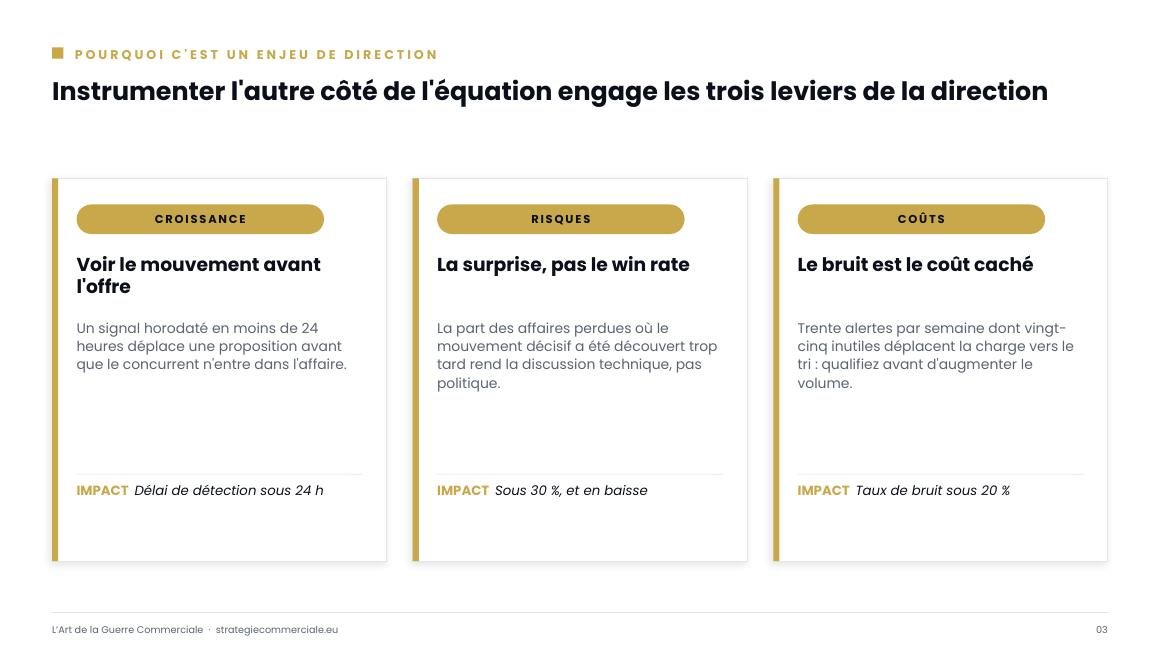
| Taux de surprise | affaires perdues avec surprise / affaires perdues | revue de perte, cinq questions | moins de 30 %, en baisse | trimestrielle |
| Couverture d’usage | affaires concurrentielles avec fiche consultée / affaires concurrentielles | outil qui héberge les fiches, croisé au CRM | 60 % | mensuelle |
| Taux de décision instruite | décisions citant un signal / décisions significatives | comptes rendus de comité | 40 % après deux trimestres | trimestrielle |
Trois remarques de méthode, qui décident de l’utilité réelle du tableau.
Le registre de sources est le seul actif durable. Il liste, pour chaque concurrent suivi, les familles de sources surveillées : grille tarifaire, offres d’emploi, avis clients, communiqués, dépôts de brevets, pages produit, partenariats, salons. Sans ce registre, le taux de couverture est une impression. Avec lui, c’est un chiffre, et il survit au départ de la personne qui l’a constitué.
Le taux de bruit est le coût caché de l’automatisation. Un agent qui produit trente alertes par semaine dont vingt-cinq sont du bruit déplace la charge de travail vers le tri. C’est la raison pour laquelle le troisième étage doit être instrumenté avant d’augmenter le volume collecté.
La couverture d’usage ne prouve pas la causalité. Elle dit qu’une fiche a été ouverte avant une offre, pas qu’elle a changé l’offre. Elle reste utile comme signal d’adoption, jamais comme preuve d’efficacité. Le biais de sélection décrit plus haut s’applique intégralement.
3.4 Le taux de surprise, seul indicateur tourné vers l’autre
Tous les indicateurs précédents mesurent la mécanique interne. Un seul mesure la position relative : le taux de surprise.
Définition : la part des affaires perdues où le mouvement concurrent décisif a été découvert par le commercial pendant l’affaire, et non par la cellule avant. C’est la part des défaites où l’entreprise a combattu sans savoir contre quoi.
Le mode de collecte est la revue de perte, durant laquelle cinq questions doivent être posées :
- Qui était le concurrent retenu, et à quel moment est-il apparu dans l’affaire ?
- Quel argument a fait basculer la décision ?
- Ce mouvement concurrent était-il connu de vous avant l’offre ? Si oui, depuis quand ?
- Si vous l’avez découvert pendant l’affaire, par quel canal l’avez-vous appris ?
- Quelle information, si vous l’aviez eue deux semaines plus tôt, aurait changé quelque chose dans votre proposition ?
La cinquième question est la plus importante, et la plus souvent supprimée pour gagner du temps. C’est elle qui transforme un ressenti de commercial en commande adressée à la cellule.
Un taux de surprise élevé n’accuse personne. Il indique qu’un étage de la chaîne ne fonctionne pas : la source n’était pas couverte, ou le signal est arrivé trop tard, ou il a été classé sans suite. Il rend la discussion technique au lieu de la rendre politique.
3.5 Le test de retrait, ou comment produire une preuve en quatre semaines
Il existe un moyen simple de prouver la valeur d’une cellule de veille : l’arrêter.
Le protocole tient en quatre semaines, avec un périmètre gelé et sans annonce publique :
- Semaine 0, mesures de référence. Sur les affaires closes des deux trimestres précédents, calculer le taux de surprise et le délai médian de réaction aux mouvements concurrents connus. Ce calcul rétrospectif est fastidieux mais faisable à partir des comptes rendus et des notes de veille déjà produites.
- Semaines 1 à 4, arrêt du brief. La collecte peut continuer en tâche de fond ; la diffusion s’arrête. Rien ne vient compenser : on observe ce que l’organisation fait sans lui.
- Conditions de validité. Pas de lancement produit majeur, pas de changement de grille tarifaire, pas de salon structurant, pas de réorganisation commerciale sur la période. Si ces conditions ne sont pas réunies, le test ne dit rien.
- Mesures en fin de période. Taux de surprise sur les affaires closes pendant les quatre semaines, nombre de questions posées spontanément à la cellule, délai de réaction au premier mouvement concurrent détecté après coup.
Le raisonnement est celui d’une quasi-expérience, c’est-à-dire d’un protocole qui compare deux périodes observées sans groupe témoin tiré au hasard. Il vaut mieux qu’une corrélation entre win rate et budget de veille, sans atteindre la rigueur d’un essai contrôlé.
Deux issues possibles, toutes deux utiles. Si le taux de surprise et le délai de réaction se dégradent, la cellule a produit une preuve que personne ne peut contester, et elle peut la présenter en comité. Si rien ne bouge et que personne ne réclame le brief, vous financez un rituel : mieux vaut le savoir et réaffecter le budget que continuer à le justifier par un chiffre qui ne veut rien dire.
3.6 La grille de qualification : empêcher le volume de noyer la décision
Une collecte automatisée sans grille de tri produit une catastrophe silencieuse. Il faut donc noter chaque signal, avant diffusion, sur trois critères de 1 à 3.
| Critère | Question posée | 1 | 2 | 3 |
|---|---|---|---|---|
| Irréversibilité | Le concurrent peut-il revenir en arrière à coût nul ? | oui, c’est un test | coût moyen | non, c’est engagé |
| Spécificité | Est-ce un mouvement ou une rumeur ? | une page modifiée | deux sources concordantes | communiqué, dépôt, recrutement confirmé |
| Impact | Quelle décision nommée change ? | aucune | une priorité de discours | une offre, un prix, un ciblage |
Total sur 9. De 7 à 9, le signal est publié dans le brief et notifié au propriétaire de l’offre concernée. De 4 à 6, il passe en vérification sous 48 heures, avec une source contradictoire à produire. De 1 à 3, il est archivé dans le journal, sans diffusion.
L’exemple canonique est celui d’un concurrent qui retouche sa page tarifaire un mardi et revient à la version précédente le vendredi. Irréversibilité 1, spécificité 1, impact 1 : le signal est archivé. Trois jours de réunion de direction évités. Ce cas est décrit en détail dans l’article sur les agents de veille et le facteur Terre, qui traite la collecte ; le présent article traite la mesure.
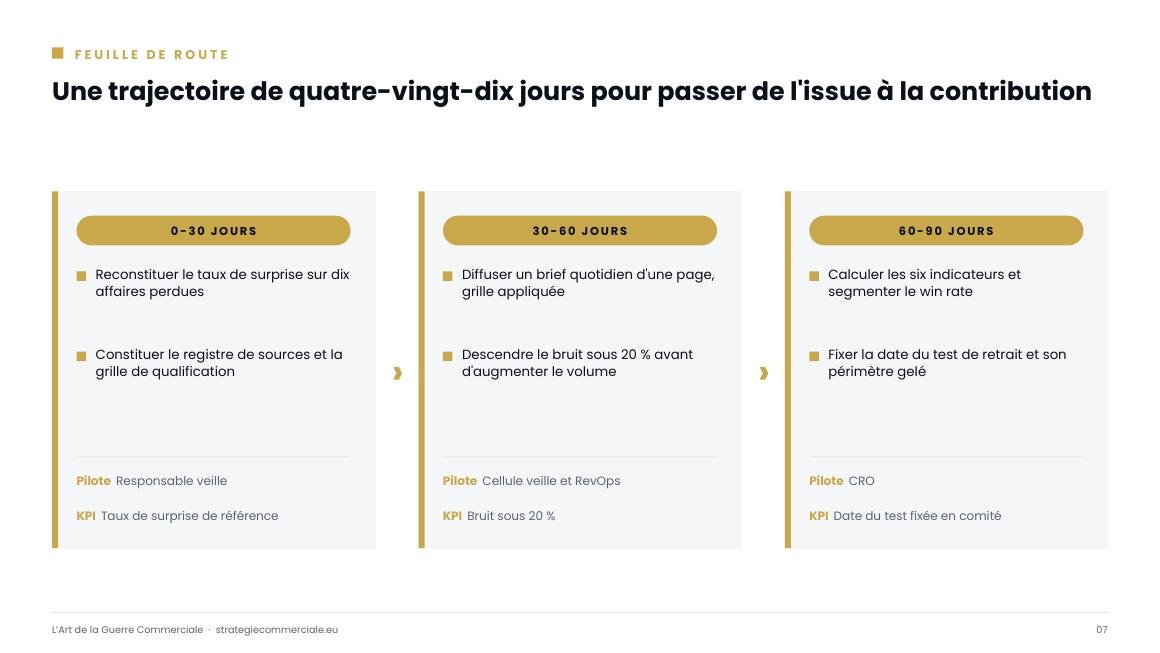
3.7 Le protocole des trente premiers jours
- Semaine 1, mesure de référence. Reconstituer le taux de surprise sur dix affaires perdues, et segmenter le win rate par concurrent, par taille d’affaire et par origine. Cette semaine ne produit aucun livrable visible et c’est normal : sans référence, aucune amélioration n’est démontrable.
- Semaine 2, sources. Constituer le registre : concurrents suivis, familles de sources, propriétaire de chaque source. Brancher la collecte sur les sources publiques, sans chercher l’exhaustivité. Douze concurrents et six familles suffisent à démarrer.
- Semaine 3, brief et grille. Diffuser un brief quotidien d’une page, avec la grille de qualification appliquée. Objectif : un taux de bruit sous 20 % avant d’augmenter le volume.
- Semaine 4, arbitrage. Calculer le premier taux de surprise, présenter les six indicateurs, et décider de la date du test de retrait. C’est le seul moment où la question du budget se pose sur des données.
Où l’analogie casse
Trois écarts, et ils sont importants.
L’ennemi de Sun Tzu a une volonté ; votre périmètre concurrentiel n’en a pas. Un général adverse décide, donc il se renseigne sur un esprit. Huit concurrents qui bougent chacun de leur côté forment un système sans intention commune, où l’information utile est moins « que va-t-il faire » que « qu’est-ce qui est en train de changer dans les conditions de la concurrence ». Cela déplace la veille du renseignement sur un adversaire vers la surveillance d’un environnement.
Une partie de ce qui fait bouger le win rate n’est pas concurrentielle. Un gel de budget, un champion qui change d’entreprise, un comité d’achat qui s’allonge : trois causes de défaite qui ne disent rien de votre renseignement et que le taux de surprise lui-même ne capte pas entièrement. C’est pourquoi il faut le lire par concurrent et non en agrégé.
知己 suppose que l’entreprise se connaît, et c’est rarement le cas. Sun Tzu pose la connaissance de soi comme un acquis. Dans la réalité, le CRM est incomplet, les motifs de perte sont saisis à la main et les commerciaux classent volontiers une affaire perdue en « pas de décision » pour éviter une revue. La moitié de la maxime est donc aussi un chantier, et c’est précisément l’absence de cette moitié qui rend le win rate disponible et tout le reste invisible.
Le mot de la fin
La veille concurrentielle souffre d’un malentendu de mesure. On lui demande de prouver sa valeur sur l’indicateur le plus éloigné de son travail, puis on s’étonne qu’elle ne puisse pas le faire, puis on conclut qu’elle ne sert à rien.
Sun Tzu donne pourtant la réponse dans la partie de la phrase que tout le monde coupe. La certitude vient de deux connaissances, et l’entreprise n’en instrumente qu’une. Le jour où la seconde devient mesurable, la conversation change de nature : on ne demande plus à la cellule ce qu’elle a rapporté, on lui demande ce qu’elle a vu avant les autres.
Un demi-poste de veille n’est pas un problème de budget. C’est un problème de preuve. Et la preuve ne se trouve pas dans le win rate.
Questions fréquentes
Combien de temps faut-il pour tenir six indicateurs ?
Deux à trois heures par mois, à condition que la collecte soit automatisée et que le CRM alimente les affaires closes. Le coût réel n’est pas le calcul, il est la revue de perte : cinq questions par affaire perdue, ce qui représente environ quinze minutes par affaire.
Faut-il acheter un outil de veille concurrentielle dédié ?
Pas au départ. Le premier chantier est le registre de sources et la grille de qualification, qui se tiennent dans un tableur. Les plateformes apportent de la valeur quand la collecte est étendue et que la diffusion doit atteindre des commerciaux sur le terrain ; elles ne règlent pas le problème de mesure, et l’un des éditeurs de référence le reconnaît lui-même.
Le win rate ne sert donc à rien ?
Il sert, à trois conditions : segmenté par concurrent et par taille d’affaire, lu en tendance sur plusieurs trimestres, et jamais présenté comme la mesure de la veille. C’est un indicateur de contexte, pas un indicateur de contribution.
Comment convaincre une direction qui ne veut pas de test de retrait ?
Proposer l’inverse : un test d’ajout. Quatre semaines avec brief quotidien sur un périmètre restreint, mesure du taux de surprise avant et après. Le dispositif est moins inconfortable et la démonstration reste possible, à condition d’accepter que la mesure porte sur une seule équipe commerciale.
Quelle différence avec une veille tarifaire automatisée ?
La veille tarifaire surveille un seul étage, la couverture, sur une seule famille de sources. Elle est utile et insuffisante : un concurrent qui change de prix sans changer d’offre produit du bruit, et un concurrent qui recrute trois ingénieurs sur votre segment ne touche à aucun prix.
Sources
Texte stratégique
SUN TZU, L’Art de la guerre, chapitre 3 (谋攻, « De l’attaque par le stratagème »), passage 知彼知己,百戰不殆 ; traduction anglaise de Lionel Giles, 1910, reprise dans l’édition présentée par James Clavell, Delacorte Press, 1983. Le mot 殆 est rendu par « péril » et non par « défaite » ; la formule « cent victoires » qui circule en français est une glose postérieure.
Études business
KLUE, « Why Using Reporting Metrics Will Get your Competitive Program the Attention it Deserves », klue.com, consulté le 7 novembre 2026. Source de la citation sur l’isolement de l’impact revenu et de la critique du win rate comme mesure de programme concurrentiel ; l’approche par comparaison des utilisateurs et non-utilisateurs de fiches y est décrite et discutée ici pour son biais de sélection.
Méthode
Le protocole de test de retrait et la grille de qualification ont été construits pour cet article ; ils ne proviennent pas d’une source publiée. Les seuils indiqués sont des points de départ à calibrer sur l’historique de chaque entreprise.